Fabbrica di short da clip stock
Centinaia di clip stock filtrate, tagliate e controllate in edit verticali pronti da pubblicare, senza aprire un editor.
- Python
- FFmpeg
- OpenCV
- YuNet
- curl_cffi
- Pexels API
- Pillow
Cosa produce
Video veri generati dal sistema.
- 456clip scaricate e scartate in automatico su circa 1.300 controllate, 322 per la presenza di volti
- 340clip rimaste nella libreria di lavoro dopo una blocklist di 504 voci tenuta a mano
- 30 / 30video dell'ultimo batch completo che passano il QC automatico
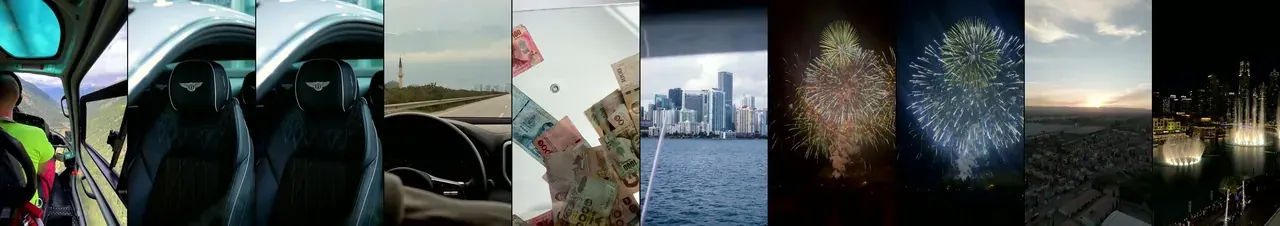
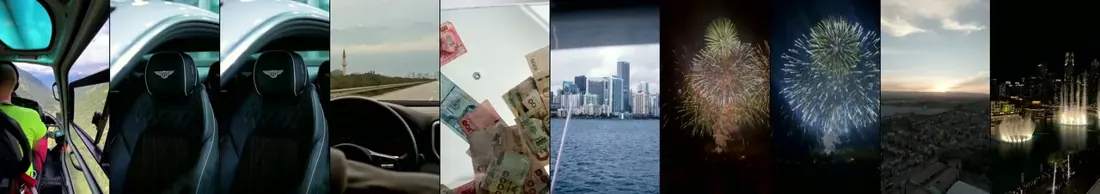
340 clip stock dentro, 49 edit verticali fuori
Cerca nelle librerie stock, filtra ogni clip su cinque frame, la porta a 1080×1920 con il grading e monta edit verticali muti a regole, poi li controlla uno per uno in automatico.
Tocca un blocco per vedere cosa fa.
- Ingresso
- AI
- Logica
- Persone
- Dati
- Uscita
Ingresso
Ricerca stock
26 query curate su Pexels e Pixabay: API ufficiali con chiave, altrimenti pagine di ricerca via curl_cffi che imita Chrome. 5 download in parallelo, max 120 MB.
- Pexels API
- Pixabay API
- curl_cffi
Passa a Filtri visivi
AI
Filtri visivi
5 frame per clip: volto YuNet ≥7,5% dell'altezza o in 2+ frame, colorfulness ≥10, deviazione luma ≥18, Laplaciano ≥22, dHash a ≤6 bit da una clip già tenuta.
- OpenCV
- YuNet
- Pillow
- ffprobe
Riceve da Ricerca stockPassa a Normalizza + grading
Logica
Normalizza + grading
Crop a 1080×1920, 30 fps, senza audio, grading contrasto 1,11 / saturazione 1,24; stessi parametri x264 ovunque, così l'unione finale non ricodifica.
- FFmpeg
- x264
Riceve da Filtri visiviPassa a Audit per query, Libreria clip
Persone
Audit per query
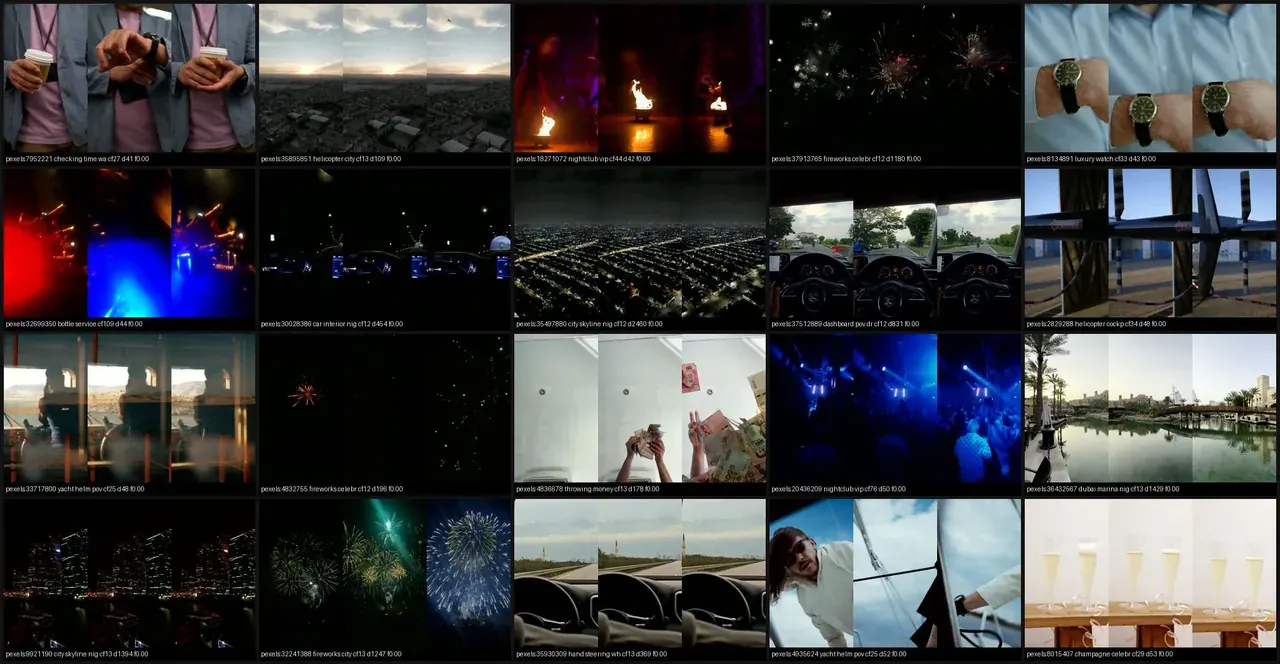
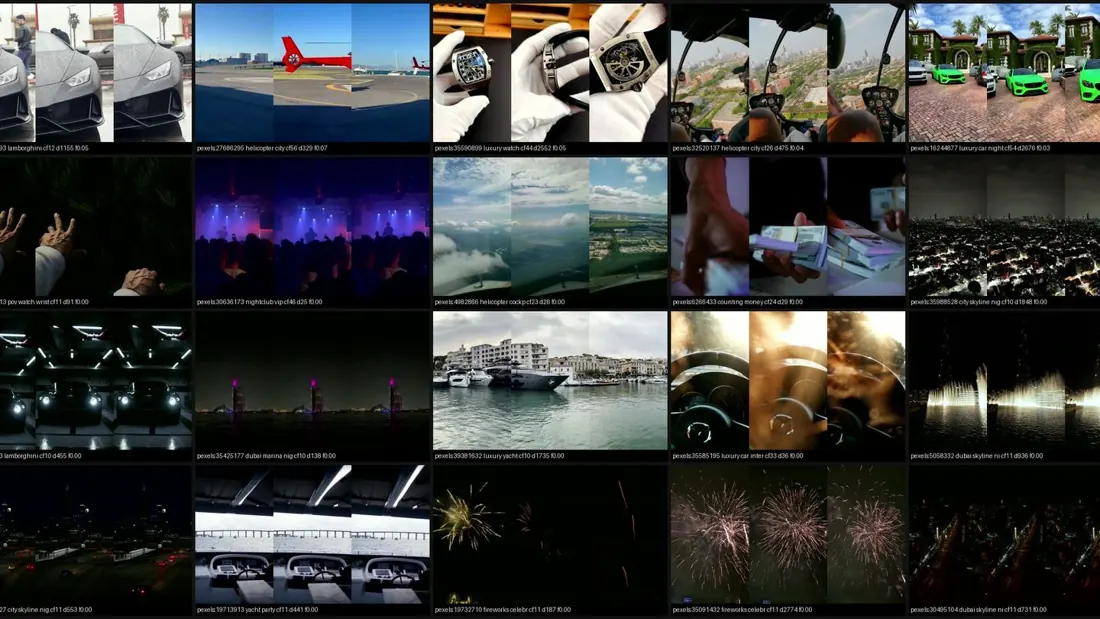
Un contact sheet per query più uno della libreria, peggiori prima; le clip sbagliate vanno in blocklist con cli.py block. 78 query provate, 26 tenute.
- Pillow
Riceve da Normalizza + gradingPassa a Libreria clip
Dati
Libreria clip
manifest.json conserva URL d'origine, metriche e utilizzi di ogni clip; 340 utilizzabili dopo la blocklist. Gli utilizzi restano salvati: niente ripetizioni tra un run e l'altro.
- JSON
Riceve da Normalizza + grading, Audit per queryPassa a Montaggio a regole
Logica
Montaggio a regole
5-8 tagli da 1,4-2,6 s per 9,5-12 s; ≥65% POV, almeno un'auto e un orologio o contanti, clip più forte in apertura, nessun riuso entro 5 video; unione in stream copy.
- Python
- FFmpeg
Riceve da Libreria clipPassa a QC automatico
Logica
QC automatico
Specifiche via ffprobe, blackdetect (fallisce oltre 1,8 s), freezedetect (fallisce da 3 s), conteggio tagli, luminosità del primo frame, contact sheet. Il pannello rigenera una volta.
- FFmpeg
- ffprobe
Riceve da Montaggio a regolePassa a Edit finiti
Uscita
Edit finiti
MP4 1080×1920 muti pronti per Reels e TikTok, l'audio si aggiunge dopo. 49 prodotti: batch a CRF 21, render singoli dal pannello a CRF 16.
- H.264
Riceve da QC automatico
Il problema
Le pagine luxury faceless pubblicano ogni giorno edit verticali a tagli rapidi. Montarli richiede minuti; trovare clip adatte richiede ore, perché lo stock gratuito è pieno di volti, riprese piatte, spot e quasi-duplicati. La ricerca 'lamborghini interior' restituiva un trattore e un videogioco, ma nessuna Lamborghini.
Cosa ho costruito
- Ho costruito il reperimento da Pexels e Pixabay: API ufficiali se c'è una chiave, altrimenti le pagine di ricerca con un client che si presenta come Chrome, perché le richieste normali ricevevano 403.
- Controllo ogni download su cinque frame campione: volti con YuNet, colorfulness di Hasler–Süsstrunk, contrasto, dettaglio col Laplaciano e un hash percettivo contro tutte le clip già tenute.
- Normalizzo ogni clip allo stesso profilo 1080×1920, 30 fps, H.264 con un grading leggero, così l'edit finale si unisce in stream copy, senza ricodifica.
- Ho scritto le regole di montaggio nell'assemblatore: 5-8 tagli da 1,4-2,6 s, almeno il 65% di riprese in prima persona, un'auto e un orologio o contanti in ogni video, la clip più forte in apertura, nessuna clip ripetuta entro cinque video.
- Ho aggiunto il QC automatico (frame neri, fermi immagine, tagli di scena, luminosità del primo frame) e strumenti di revisione che stampano un contact sheet per ogni query, così le query deboli si eliminano e le clip sbagliate restano bloccate.
La parte difficile
La pertinenza. I filtri prendono volti e riprese spente, non una Toyota tra i risultati di 'luxury car interior'. I controlli a campione continuavano a perderle, quindi sono passato a un audit della libreria query per query: ha eliminato sette query quasi senza risultati utili e portato la blocklist a 504 clip.
Risultato
Su circa 1.300 clip scaricate, 456 sono state scartate in automatico e altre 504 bloccate a mano: ne restano 340 nella libreria di lavoro. Il motore ha prodotto 49 edit da 9,5-12 secondi e l'ultimo batch completo ha passato il QC 30 su 30. Il report del progetto stima in linea col brief il 72-78% delle clip di ogni video; il limite è il catalogo gratuito.
Il mio ruolo
Progetto in solitaria. Ho fissato il brief visivo partendo da reel virali di riferimento, bocciato gli output clip per clip con le motivazioni scritte in un playbook e deciso cosa bloccare; il Python l'ha scritto in gran parte Claude Code, anche in lunghe sessioni notturne senza supervisione.